
从研发瓶颈到验证瓶颈:AI时代医疗人工智能研发中的“研发—验证速度失配”及人机协同验证体系
From Development Bottlenecks to Validation Bottlenecks: Development–Validation Speed Mismatch and a Human–AI Collaborative Validation Framework for Medical AI
摘要
背景:AI编程、自动训练和批量推理可能提高医疗人工智能候选成果的生成速度,但工程与临床评价仍受专业人员时间、评价标准和证据质量约束。开发提速是否转化为有效交付,取决于完整研发链条的处理能力,而非单一生成环节。
目的:建立研发—验证速度失配的操作性定义,说明验证积压与验证债务的区别,并提出兼顾效率与独立专业判断的人机协同验证框架。
方法:结合定向叙述性文献检索、排队系统的流量守恒思想及两份子殷项目交接包的文档核查,构建三级责任体系和前瞻性评价方案。当前案例材料限于工程摘要及其记录,不涉及原始影像重算或新的临床评价。
框架与观察:将研发预验证、独立技术工程验证、临床专业验证划分为三个责任层级,以固定评价规范、候选版本绑定、结构化问题单和受控知识回流连接。跟骨项目记录显示,18个锚点条件实验通过既有几何检查时,8例的锚点歧义仍未解决;肺项目记录中的4例候选通过所列工程检查,但专业复核仍为待办。这些记录说明验证层级和判断对象需要明确区分,尚不能证明组织存在持续速度失配或干预具有因果效果。
结论:医疗AI研发的效率评价应同时报告验证完成周期、专业人员工时、合格交付量和严重缺陷漏检情况。验证知识前移应提高提交质量,独立工程与临床判断则保留在相应责任层级。本文提供可实施、可证伪的研究方案;其效率与质量效应仍需前瞻性数据验证。
关键词:医疗人工智能;研发效率;验证债务;人机协同;独立验证;医工转化
Abstract
Background: AI-assisted coding, training and inference may increase the production of candidate medical AI outputs without a corresponding increase in engineering and clinical validation capacity. Faster generation therefore does not necessarily lead to faster qualified delivery.
Objective: To operationalize development–validation speed mismatch and propose a human–AI collaborative framework that preserves independent professional judgment.
Methods: We combined a targeted narrative literature search, flow-conservation reasoning and document-level examination of two Ziyin project handover packages. We then specified a three-level responsibility model and a prospective evaluation protocol. No original medical images were reprocessed and no new clinical assessment was performed.
Framework and observations: The framework separates development pre-validation, independent engineering validation and clinical professional validation. Version-bound evidence, structured feedback and controlled rule updates link these levels. Existing calcaneal project records describe 18 conditional experiments passing geometric checks while anatomical anchor ambiguity remained unresolved in eight cases. Four lung candidates passed the documented engineering checks while professional review remained pending. These observations illustrate differences between validation claims; they do not establish a sustained throughput mismatch or an intervention effect.
Conclusion: Evaluation should jointly consider validation cycle time, professional effort, qualified throughput and escaped serious defects. Moving validation knowledge upstream should improve submission quality while preserving independent judgment. The proposed efficiency and quality effects require prospective testing.
1 引言
医疗AI团队的研发成果包含代码、模型权重、分割结果、测量工具、三维几何及其组合。生成其中一种成果不等于完成一个可使用的医疗任务。例如,生成可加载的STL只能回答格式与部分几何问题;测量值能够显示,也不意味着其解剖标志点、参考平面和临床解释已经成立。因此,开发速度与有效交付速度应分别测量。
AI对研发速度的影响并非恒定。Peng等的受控实验报告,在特定JavaScript任务中,使用GitHub Copilot的参与者完成任务更快[1];Becker等对熟悉自身开源项目的开发者开展随机试验,却观察到2025年初工具条件下任务完成时间增加[2]。METR于2026年公布后续研究设计调整,指出参与选择和并行任务计时影响了新的效应估计[3]。这些研究对象并非医疗研发组织,支持的结论是效果依赖任务与情境,不能直接证明医疗AI行业普遍发生验证瓶颈迁移。
医疗AI评价文献已经强调技术性能与临床价值之间的距离。DECIDE-AI面向早期临床研究,关注实际工作中的系统表现和人因问题[4];FUTURE-AI覆盖开发、验证、部署与持续监测[5]。2026年的相关研究和评论进一步使用“validation debt”讨论统计表现、临床运行和快速开发之间的证据缺口[6,7]。因此,本文不将“验证债务”作为首次提出的术语,而尝试在医疗三维工程研发中明确其统计单位、责任归属和可干预机制。
本文的核心命题是一个有条件的组织假设:当合格候选成果的到达负荷持续超过某一验证环节的有效处理能力,而且返工、版本变化与任务波动未被控制时,研发加速可能转化为验证积压。相应改进需要同时作用于提交质量、验证能力和任务进入速率。
2 文献与案例材料方法
本稿于2026年9月26日通过网页检索及出版机构、PubMed/PMC、arXiv和研究机构原始页面进行定向叙述性检索。主题词包括AI developer productivity、medical AI validation、validation debt、DECIDE-AI、FUTURE-AI、image analysis validation metrics、Little queueing formula和interrupted time series。优先纳入与研究问题直接相关的原始研究、原始框架论文及共识指南,区分预印本、期刊研究、评论和机构更新。此过程未进行预注册或数据库穷尽检索,也未开展双人独立筛选,不能称为系统综述。
案例核查限于两份已存在的工程交接包:CalcAI_Engineering_V5_20260926.zip和Lung_V096_R1_20260926.zip。读取README、结构化摘要及相关几何核查记录,提取工程状态、判断对象和证据边界。选择这两份材料是因为它们包含可追溯的版本与验证状态;它们属于目的性案例,不能代表全部项目,也不构成独立临床测试集。本稿未重新执行原实验,文中数量均注明为包内记录或由记录直接汇总。
文献承担理论定位与研究设计依据;内部记录承担机制示例;未来前瞻性研究承担效应检验。三类证据不得相互替代。本文公开范围为方法框架与非识别性工程摘要。后续前瞻性研究应在启动前完成相应的研究资料授权及伦理审查或豁免判断。
3 核心概念与可测量模型
3.1 先固定成果单位和评价范围
本文将“验证工作项”定义为具有明确用途、输入来源、候选版本、评价规范和责任人的可追踪评价任务。对于病例工作项,基本单位为病例与任务的组合;同一病例同一任务的重复推理、多个骨块和返工版本,均通过父子关系归入同一主工作项。模型版本或软件功能级验证应单独建表,不能和病例级任务混合计算吞吐量。
一次可受理提交至少绑定输入版本或哈希、模型与代码版本、运行环境、输出版本、评价规范版本和证据位置。更换模型或参考平面导致旧结论失效时,应记录重开原因及受影响范围,不能仅覆盖原文件。本文所称合格交付,是完成该用途预先要求的全部验证关口;它与候选生成、技术检查通过或临床部署批准分别计数。
3.2 研发与验证的速度失配
以相同观察窗口和工作项定义计算:研发提交速率为每周首次进入验证的合格受理工作项数;阶段结论产出速率为该周完成相应阶段评价的数量;最终合格交付速率则仅统计达到全部预定要求的工作项。完成评价可以得到通过、退回、否决等结论,故评价吞吐量不能直接等同于通过数量。
对整个验证流程的未结工作项存量,可使用以下守恒关系。
其中B为期初未结存量,A为首次进入的新工作项,O为此前已结项任务的重开数量,P为满足预定要求后通过结项的数量,X为有依据的否决、撤回或取消结项数量。仍在流程内的返工不另增加主工作项,但必须计入阶段访问次数和人工工时。取消任务能减少队列,却不增加合格交付,因此P和X必须分别报告。
不同任务耗时差异显著时,应进一步以工时衡量负荷。对验证阶段j,定义λⱼ为每周到达的阶段访问次数,包含返工再提交;sⱼ为每次访问平均需要的专业人员分钟数;Hⱼ为该周实际可提供的同类专业人员分钟数。
在服务类型和估计口径可比的条件下,ρⱼ持续高于1提示该阶段需求超过可用能力;它是容量诊断量,不是缺陷风险评分。Hⱼ为零时单列“无可用容量”,不强行计算比值。平均负荷低于1也可能因任务波动、预约窗口、阻塞和紧急插单产生长等待;共享同一批专家的队列必须合并考虑容量,不能重复分配同一段时间。
Little定律提供了稳态下在制品、有效到达率与平均停留时间之间的联系[8]。应用时需保持系统边界一致;系统停留时间包括服务,排队等待时间则仅包括未开始服务的部分。对于持续增长的非稳态积压,本研究优先展示逐周到达、结项和存量,不套用稳态关系宣称因果。
3.3 验证积压与验证债务
验证积压是尚未完成评价的工作项集合。处于计划周期内、有明确责任人且证据完整的正常队列,不必全部称为债务。本文将“验证债务”操作性界定为:相对于预定用途和验证计划仍缺失、过期或已失效的必要证据义务。其本金是需要补做的工作;额外代价可能来自上下文恢复、依赖版本变化、重复沟通和旧证据失效。
这一用法与机器学习技术债讨论相联系,但不等同于所有维护成本[9]。为避免未经验证的综合评分,本研究分别报告逾期工作项数、缺失证据类别、证据失效数量、最久等待时间和剩余工时估计区间。等待越久是否必然导致返工越多,是需要观察的问题,而不是模型先验结论。
4 三级责任体系与知识回流
4.1 验证责任应与判断对象匹配
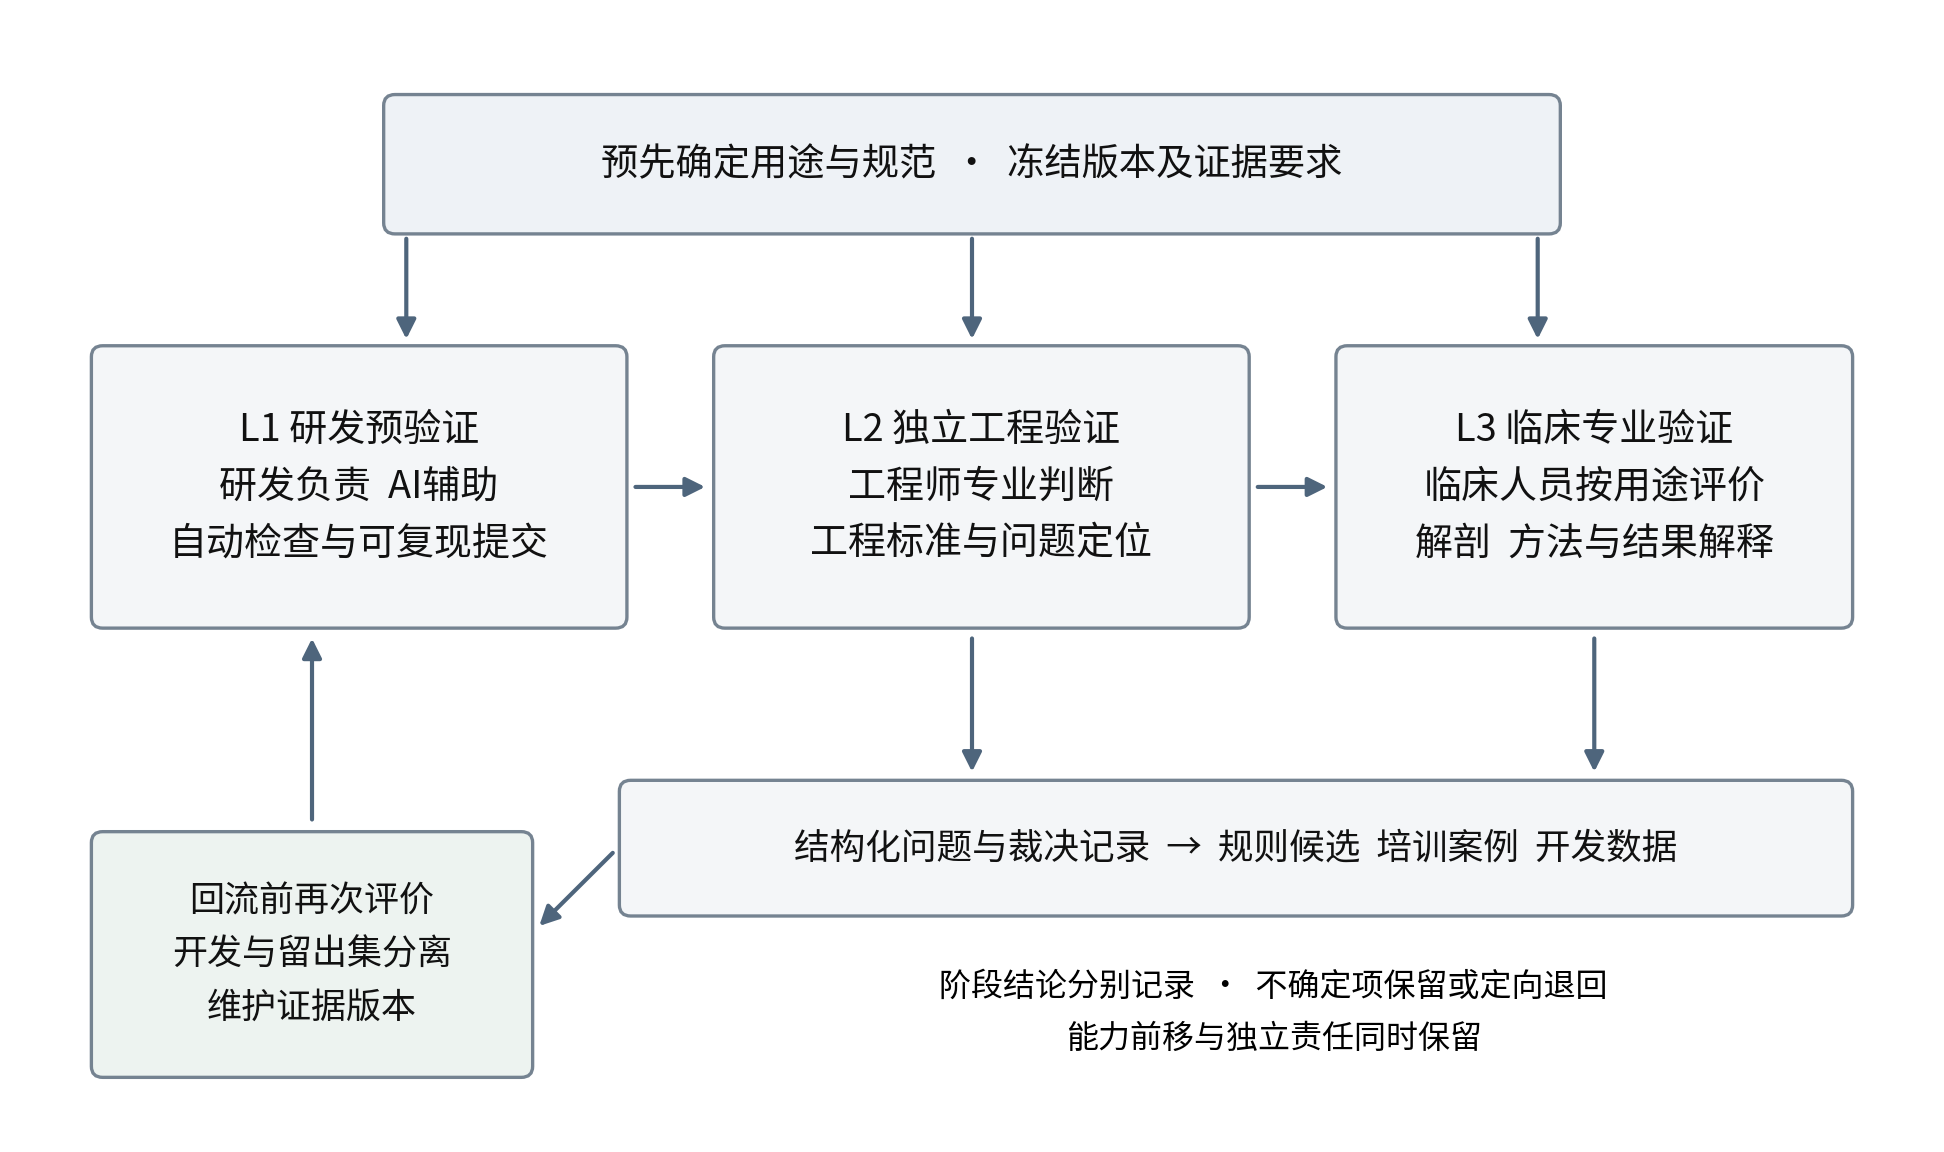
自动检查是多个阶段可使用的工具,不另设为无人承担责任的审批层。研发预验证侧重实现是否符合预定规范;工程独立验证侧重输出是否符合专业工程标准;临床专业验证侧重解剖、方法和预定用途是否成立。实际流程可存在并行评价和定向退回,三级并不意味着所有问题必须逐人串行传递。
表格可左右滑动查看
| 层级 | 责任主体 | 核心判断与典型证据 | 结论边界 |
|---|---|---|---|
| L1 研发预验证 | 研发人员负责,AI辅助 | 功能与异常处理、输入输出绑定、数值一致性、单位与坐标、已确认规则的自动检查 | 可提交工程评价;不能自行宣称临床正确 |
| L2 独立技术工程验证 | 非该项主要实现者的合格工程师 | 分割边界、结构完整性、测量实现、骨块几何、模型质量;形成签署的问题单与结论 | 工程符合性;保留无法判定和需临床解释的情况 |
| L3 临床专业验证 | 对应用途的临床专业人员 | 解剖关系、测量方法适用性、复位或规划合理性、结果解释与使用条件 | 针对明确用途的专业判断;单次复核不等于证明患者获益 |
临床评价本身还可包括离线专家评估、静默运行、早期临床研究和进一步的有效性研究。医生看过一个结果,不等于完成产品的临床验证。涉及真实诊疗的后续研究应按适用设计执行;DECIDE-AI和CONSORT-AI是相应研究的报告依据,不能把报告清单当作产品批准或有效性证明[4,10]。
4.2 独立性需要可检查的安排
关键评价不应由同一人员独自实现并最终放行。资源有限时,可在团队内交叉复核或邀请外部专业复核,记录评审者与开发者角色关系。对高影响结论,预先冻结参考标准和阈值;可行时使评价者对候选来源、版本顺序或算法评分盲法。若不宜盲法,应报告原因和潜在偏倚。
同一模型生成代码和测试可能产生相关遗漏;更换提示词、模型名称或增加一名AI审阅者,也不能自动获得证据独立性。独立实现的检查可用于核查某个几何计算,但仍不能替代参考标准、真实工作流和临床意义的评价。规则之间冲突时,应保留争议状态并交由适当专业人员裁定。
4.3 把反馈转化为可复用知识
结构化问题单记录问题位置、问题类型、严重程度、发现阶段、适用规范、证据、根因判断、修复版本和复验结果。根因未确定时使用“待判定”,不把所有修改都标记为算法错误。无效往返可进一步分为资料不完整、格式错误、规范未明确、实现缺陷、专业标准冲突与临床不确定性。
问题回流有三条路径。可形式化且已达成专业共识的判断转化为规则与回归检查;需要经验但暂不能形式化的判断转化为操作说明和培训案例;适合学习的数据进入经授权的训练或开发集合。后两者不必强行转为自动判断。新规则先在历史开发样本中检验,再进入影子运行和独立留出评价,达到预定要求后才纳入正式检查集。
回流时尤其要防止验证集污染。作为本轮独立评价的病例和专家答案不得立即用于调参后再报告同一轮性能;若进入下一轮训练,应重新划分后续测试集,并保持患者级分组。开发、阈值校准与最终评价分离,所有变动保留版本。
4.4 让研发入口服从验证能力
仅把知识写进提示词不足以处理容量不足。组织应设置可受理提交规范、按阶段显示等待与工作中数量、限制同时处于活动验证的候选版本,并预留复杂病例和紧急任务的专家时间。若某阶段无法消化新任务,可以合并重复候选、冻结短期非必要版本变化、将研发转向规则建设和故障复现;不能把减少复核或放宽阈值作为默认提速手段。
对低影响的工程变更,可按预先确定的影响范围复验;对解剖命名、坐标转换、临床测量或复位逻辑等关键变化,则需重新评估相应下游结论。风险分层与三级责任是两个不同维度:前者决定验证深度,后者决定谁作出何种判断。
5 子殷项目的文档级案例观察
5.1 跟骨复位显示几何通过与专业判断的差异
CalcAI V5摘要记录了22项研究任务,其中18项为8例锚点歧义病例的条件实验。18项均通过原有几何检查,但摘要中的锚点歧义解决数为0;这些实验检验的是“给定锚点假设后能否产生满足所列几何条件的候选”,没有识别出正确解剖锚点。多个假设还可能对应相同结构,因此不能把实验次数当作独立病例数或有效复位数。
包内另记录11份人工版本、132个碎片,0份同时通过现行接触与穿透门槛。该现象并不能直接判定人工版本不合格或自动规则错误。随包的独立几何核查记录,对每例最严重相交对抽取5个位置,共55点进行不同实现的距离与内外判断检查,支持被检查位置上的几何计算一致性;它仍不覆盖所有位置,更没有解决阈值是否符合临床目的的问题。
这构成了具体的验证研究对象:需要分开评价检测器的计算正确性、门槛的专业适用性和人工参考的可靠性。若仅优化原目标函数或增加搜索次数,即使数值改善,也不能假定临床合理性同步改善。图像分析评价文献同样提示,指标必须与目标任务及实际关注的问题对应[11,12]。
5.2 肺段重建显示证据状态应逐层标记
Lung V09.6摘要包含4例候选。其记录均显示分区并集与原左上叶一致、分区重叠体素数为0、越出左上叶体素数为0,并保留24个未变结构;同一摘要同时标记专业复核为PENDING、临床验证为false。这些检查可支持分区完整性和部分变更范围的判断,但不能证明支气管对应、肺段命名或切除规划的解剖正确性。
因此,候选状态应允许同时表达“工程检查通过”和“专业判断未完成”。这比单一绿色通过标记更能准确表明下一项工作。此处引用的是固定版本的交接记录,不推断该项目此后的实时状态。
表格可左右滑动查看
| 案例材料 | 已记录的观察 | 可支持的解释 | 尚不能支持的结论 |
|---|---|---|---|
| CalcAI V5 条件实验 | 18项几何通过;8例锚点歧义仍未解决 | 条件几何证据不足以确定锚点 | 18例复位成功、临床正确率 |
| CalcAI V5 人工对照 | 11份人工版本均未同时通过现行两类门槛 | 应研究标准、检测器与参考之间的分歧 | 人工判断失效或阈值必然正确 |
| Lung V09.6 | 4例所列工程检查通过;专业复核待办 | 工程证据与解剖证据需要分层 | 肺段准确率、临床有效性 |
5.3 当前材料仍缺少的关键证据
两份材料没有构成统一口径的完整验证事件表,不能可靠计算首次受理至最终通过的时间、实际人工分钟数或逐周验证产能。专业复核待办可能来自计划安排、资料不足、标准争议或容量限制,不能仅凭待办状态认定人员效率低下。
双下肢负重位CT测量、胸腰椎/脊柱和运动分析可作为后续迁移场景,但本稿未核查它们的原始项目记录,不报告这些项目的实证结果。不同专科应分别定义质量终点,不能把分割、复位和运动测量直接合并成一个准确率。
6 前瞻性研究设计
6.1 研究目的与分析单位
建议采用单组织多项目的前瞻性混合方法研究,先完成数据可用性预试验,再开展分阶段流程干预。主要评价完整的分层验证流程对工程验证完成时间的影响;临床阶段作为独立次要队列分析。单位为连续纳入、符合预先条件的主工作项,同一病例、开发者及验证者的相关性纳入分析。所有拒绝受理、撤回、超期和失败工作项均保留。
模型或功能版本级任务与病例级任务分别分析。对病例任务可先按项目、难度、数据质量和预期用途分层。复杂病例的定义必须在知道验证结果前确定,例如以骨块数量分层时,应提前冻结阈值,不能根据最终通过与否反向命名“困难”。
6.2 干预与对照
对照阶段为记录完整的既有研发与验证流程;干预阶段同时增加固定提交规范、自动检查、研发预验证、结构化问题单及受控回流。两阶段保留相同独立专业评价要求。比较的是验证组织方式,不是“有医生”和“无医生”的差别,也不能为了形成对照而撤掉原有安全措施。
可先进行约2周的日志预试验,检查事件是否可追踪、主动工时是否可记录。随后以约6至8周基线和6至8周干预作为运营排期草案;正式观察长度由任务到达量、事件频率、效应精度和人员安排决定。不能将这些时间长度当作统计充分性的保证。
若不同项目能够分批切换,保留日历同期的未切换项目作为比较,并尽可能事先随机确定切换次序。若只剩少数异质项目,不能依靠少量集群获得稳健的总体因果结论。若最终采用前后观察,应控制时间趋势并谨慎解释;中断时间序列可作为数据量足够时的分析方法,需处理季节性、自相关和同期变化[13]。任何具体研究设计在启动前确定,不根据显著性结果更换主分析。
6.3 主要终点与质量约束
主要效率终点为首次L2受理至最终L2通过的历时,以工作日计并同时保存自然时间。返工时间保留在总历时中;中途取消或最终否决作为竞争结局报告,不当作成功通过。未结束任务为截至预定观察点的未完成记录;不能只分析已经通过的项目。若在观察窗口内通过比例不足以估计中位时间,则报告固定窗口内通过累积发生率及未结存量。
主要质量约束为独立审计中发现的、已穿过前级关口的严重缺陷比例。严重程度由预先定义的错误后果分类确定,至少区分影响关键解剖/测量/规划结论的错误和一般展示错误。先比较严重缺陷率差及区间;如要主张非劣效,必须由相应专业人员在查看效果前确定可接受界值并完成样本量设计。差异不显著或小样本未发现缺陷,均不等于证明安全相当。
次要终点包括L1/L2/L3主动工时、各阶段等待时间、首次通过率、返工访问次数、规则适用覆盖率、合格交付量及取消数量。还需报告每个合格交付所消耗的总人工分钟数,防止仅把工作从工程师转移给研发人员却宣称系统效率提高。医生验证依赖专门时间表时,单独报告等待原因与可提供时间。
表格可左右滑动查看
| 指标 | 操作口径 | 防止误读 |
|---|---|---|
| 首次通过率 | 无退回即通过L2的主工作项数 / 所有首次受理且已有首次结论的工作项数 | 同时报告首次结论仍待定的数量 |
| 最终通过比例 | 固定随访窗口内最终通过数 / 该批全部符合条件的受理数 | 另列未完成、否决和撤回,统一随访窗口 |
| 工程师负担 | 全部L2活动计时的人员分钟数,含返工与沟通 | 多人同时参与分别累计;不能用修改次数代替工时 |
| 自动检查覆盖率 | 已执行且适用的固定检查义务数 / 全部适用检查义务数 | 分母来自冻结检查集,并同时报告漏检与误报 |
| 严重缺陷漏检 | 独立审计发现严重漏检的工作项数 / 被独立审计的工作项数 | 抽样审计需记录概率并按设计加权 |
| 合格交付速率 | 每观察周达到全部预定关口的主工作项数 | 重复推理、条件实验和取消不计入 |
6.4 对五项假设的可证伪表述
H1:在可比任务与可用验证工时相近的条件下,较高AI使用强度与更高的验证到达负荷及存量增长相关。若AI主要减少返工而未增加负荷,则不支持此方向。仅观察已普遍使用AI的组织不能识别“采用AI”的因果效应;需要前期可比基线、外生切换或单独设计的任务试验。
H2:固定提交规范和研发预验证降低每个首次受理工作项中由L2发现的可前置检查问题数,且被拒绝受理和长期滞留L1的比例未异常上升。不能把问题藏在入口外视为质量改善。
H3:自动检查与预验证降低L2对常规问题的累计主动工时,同时未显著增加总人工负担或严重漏检。由于干预包含多个组件,主研究只能估计组合流程效果;若要分解自动化和培训的单独贡献,需另行分阶段或析因研究。
H4:结构化反馈形成经独立评价后可稳定使用的新增规则,提高固定范围内的自动检查覆盖,并减少后续同类问题复发。评价须发生在不同时间段或留出工作项,不能用产生规则的同一批错误证明规则的泛化效果。
H5:分层流程缩短验证历时,并满足事先规定的质量约束和独立复核要求。若只有速度改善、质量界值未满足或证据不足,应报告效率信号,不能宣称实现了完整目标。
6.5 统计分析与偏倚控制
先绘制逐周到达、通过、否决/撤回、未结存量及工时,并按项目分层。时间终点保留全部纳入工作项,用适合竞争结局和删失的时间分析报告通过概率与区间;在样本支持时加入任务难度、数据质量、人员、项目和日历时间。缺陷次数可用带有适当暴露量的计数模型,首次通过可用二项模型。病例及人员的重复记录须考虑聚类,少量项目时避免依赖不可靠的集群渐近估计。
样本量依据主要终点的最小有意义变化、基线分布、聚类程度和未完成比例估计,并检验质量约束是否需要更大样本。预试验用于估计这些参数,不先指定“数十例足够”。除主要假设外,其余比较列为探索性;报告效应量、置信区间与全部计划比较,不仅报告P值。
主要偏倚包括后期病例变简单、评价标准放宽、开发与评价者学习、工具升级、人员扩充、团队间知识泄漏和选择性提交。应冻结或记录规范与模型变化,保持连续入组,保留完整退回历史,按预定层级校正或分层。对被认为自动通过的工作项也要进行独立抽样审计,避免只审查报警项造成验证偏倚。严重分歧由独立裁决流程解决,先保留各评价者的原始判断。
日志缺失不填0。记录缺失原因并比较干预前后完整性;存在足够依据时才使用预定缺失数据处理方法,并进行敏感性分析。访谈工程师和医生时,重点询问负担是否减少、哪些问题仍难判定、规则是否造成额外操作,而非只询问对AI的满意度。
7 讨论
7.1 贡献是可检验的组织机制
技术债、临床转化障碍和验证不足已被反复讨论[4-7,9]。本文的潜在贡献在于将这些问题具体化为可记录的工作项、阶段负荷与证据义务,并将几何正确性、专业适用性和临床价值分开。在医学三维研发中,同一成果经常跨越图像、解剖、几何、软件和实际操作,明确这些边界有助于定位真正需要补足的证据。
上述机制不能被解读为医生或工程师是研发拖慢的原因。验证等待可能是上游低质量提交、关键标准未达成共识、任务优先级频繁变化或稀缺时间未被组织安排的结果。对于低负荷团队,主要瓶颈也可能仍在数据获取、算法能力或工程稳定性。瓶颈迁移应通过记录判断,而非用时代叙事替代测量。
7.2 自动验证也需要被验证
自动化能检测哪些错误、漏掉哪些错误、在何种输入下失效,均应成为研究对象。跟骨记录中的人工版本与几何门槛分歧说明,检查器数值可重复与其判定规则适用,是两个不同问题。阈值不能仅为了提高通过率而调整;若专业共识确认应调整,需发布新的规范版本,并在独立数据上重新评价。
对不确定性较高的任务,“无法判定”是可接受的输出。Kim等在分类场景中将需要人工处理的灰区纳入运行评价,为讨论安全要求与人工负荷的关系提供了相关思路[6];但其分类阈值方法不能直接当作三维复位或肺段解剖的合格标准。本文需要的是领域对应的证据设计,而非把一个任务的分数移植到另一个任务。
7.3 临床AI全栈研发工程师的合理边界
Clinical-AI Full-Stack R&D Engineer可作为能力画像:能够开发AI与软件,理解医学工程数据、几何和质量标准,并将临床问题转化为可测试的需求。“研发能力×医学工程能力×临床问题理解能力”在本文中只是互补关系的概括,不是经过验证的乘法能力测量模型。
这类角色应能准备可复现提交、解释限制、定位争议和把专业反馈转化为候选改进。它不赋予临床执业权限,也不免除独立复核。组织还需把规则、案例和评价方法沉淀为共享能力,否则仅培养一个跨领域骨干,可能形成新的单点依赖。
7.4 效率收益可能伴随新的负担
自动检查会产生误报,记录会占用时间,过度固定的流程可能限制探索。研究应同时测量这些代价,允许将尚无明确验收标准的实验标记为探索任务,单独管理其证据要求。研究候选可以快速迭代,但其状态必须明确,不能通过标签变更进入已验证交付序列。
当提交质量改善后,验证仍可能因临床专业时间不足而积压。此时需要更可预测的评审窗口、人员安排和任务优先级。加快研发、建设验证知识和控制活动任务数应协同进行,不能假设自动化最终可以消除所有专业人员需求。
7.5 局限性
本文为方法框架与研究方案,尚无前瞻性干预结果。两份目的性选取的工程记录来自同一组织,存在选择偏倚和记录不完整,且文档核查不能替代原始实验复现。所举观察可以说明验证结论的范围差异,不能估计缺陷发生率、验证债务总量或临床效益。
研发提速文献与医疗工程任务存在外部效度差异;排队模型简化了技能匹配、批处理和共享专家资源;拟议岗位概念尚未经人才研究验证。后续研究应明确哪些改进能够跨项目复用,哪些必须由专科重新定义。任何“全球首次”“普遍提效”或“临床安全已证实”的表述均不属于本稿结论。
8 结论
AI辅助研发可能提高候选成果的生成速度,但医疗AI的有效交付仍依赖与用途相匹配的验证证据。研发—验证速度失配应通过工作项负荷、可用容量、未结存量和完成周期进行检验。验证知识前移、分层独立判断与结构化回流构成了一个可实施的改进框架,其价值应由效率、质量和专业人员负担共同评价。
子殷现有工程记录已经提供了构建研究问题的具体材料,下一步需要形成统一事件记录和前瞻性比较。本文主张的组织能力,是使专业知识能够被明确表达、持续复用并在适当边界内自动化,同时为尚需专业判断的问题保留责任与证据。
参考文献
[1] Peng S, Kalliamvakou E, Cihon P, Demirer M. The Impact of AI on Developer Productivity: Evidence from GitHub Copilot. arXiv, 2023. arXiv:2302.06590. https://arxiv.org/abs/2302.06590 (预印本)
[2] Becker J, Rush N, Barnes E, Rein D. Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. arXiv, 2025. arXiv:2507.09089. https://arxiv.org/abs/2507.09089 (预印本)
[3] Becker J, Rush N, Cunningham T, Rein D, Mahamud K. We are Changing our Developer Productivity Experiment Design. METR, 2026-02-24. https://metr.org/blog/2026-02-24-uplift-update/ (机构研究更新)
[4] Vasey B, Nagendran M, Campbell B, et al. Reporting guideline for the early-stage clinical evaluation of decision support systems driven by artificial intelligence: DECIDE-AI. Nature Medicine. 2022;28:924–933. https://doi.org/10.1038/s41591-022-01772-9
[5] Lekadir K, Frangi AF, Porras AR, et al. FUTURE-AI: international consensus guideline for trustworthy and deployable artificial intelligence in healthcare. BMJ. 2025;388:e081554. https://doi.org/10.1136/bmj-2024-081554
[6] Kim YT, Kim H, Bahl M, et al. Defining operational safety in clinical artificial intelligence systems. npj Digital Medicine. 2026;9:281. https://doi.org/10.1038/s41746-026-02450-7
[7] Pujol O, Oettl FC, Oeding JF, et al. From code to care in hours: Why “go fast and fix things” is the new medical imperative. Journal of Experimental Orthopaedics. 2026;13:e70768. https://doi.org/10.1002/jeo2.70768 (评论)
[8] Little JDC. A Proof for the Queuing Formula: L = λW. Operations Research. 1961;9(3):383–387. https://doi.org/10.1287/opre.9.3.383
[9] Sculley D, Holt G, Golovin D, et al. Hidden Technical Debt in Machine Learning Systems. Advances in Neural Information Processing Systems. 2015;28. https://papers.nips.cc/paper/2015/hash/86df7dcfd896fcaf2674f757a2463eba-Abstract.html
[10] Liu X, Cruz Rivera S, Moher D, Calvert MJ, Denniston AK. Reporting guidelines for clinical trial reports for interventions involving artificial intelligence: the CONSORT-AI extension. Nature Medicine. 2020;26:1364–1374. https://doi.org/10.1038/s41591-020-1034-x
[11] Maier-Hein L, Reinke A, Godau P, et al. Metrics reloaded: recommendations for image analysis validation. Nature Methods. 2024;21:195–212. https://doi.org/10.1038/s41592-023-02151-z
[12] Reinke A, Tizabi MD, Baumgartner M, et al. Understanding metric-related pitfalls in image analysis validation. Nature Methods. 2024;21:182–194. https://doi.org/10.1038/s41592-023-02150-0
[13] Lopez Bernal J, Cummins S, Gasparrini A. Interrupted time series regression for the evaluation of public health interventions: a tutorial. International Journal of Epidemiology. 2017;46(1):348–355. https://doi.org/10.1093/ije/dyw098 (更正:10.1093/ije/dyaa118)
附录A 最小数据采集字典
建议以主工作项表、事件表和问题表关联保存。以下为拟议字段,不代表已经部署采集。时间使用带时区的ISO 8601格式,分析时统一时区;原始时间不覆盖。患者映射仅保留于既定授权环境,研究导出使用去标识编号。
表格可左右滑动查看
| 表与字段 | 定义或取值 | 记录要求 |
|---|---|---|
| 主表 work_item_id | 唯一验证工作项编号 | 不随返工重编号;重复版本关联原项 |
| project task_type case_key | 项目、任务类型、病例研究编号 | 病例级与版本级任务分开 |
| intended_use risk_class complexity | 用途、影响分类、入组前难度 | 冻结定义及确定时间 |
| input model code environment version | 输入、模型、代码、运行环境版本 | 必要时绑定哈希;不导出敏感路径 |
| acceptance_spec_version | 评价规范及阈值版本 | 变更记录原因与适用起点 |
| ai_exposure | AI工具版本及实际用途 | 区分代码、模型、测试、审阅辅助 |
| outcome outcome_time | 通过、否决、撤回、未完成及时间 | 未完成不填通过或0工时 |
| 事件表 event_id stage event_type time | L1/L2/L3;受理、开始、暂停、恢复、退回、重交、结论 | 逐次追加;不覆盖首次受理时间 |
| actor_key active_minutes pause_reason | 人员研究编号、主动工时、暂停原因 | 多人分别记时,区分等待与工作 |
| 问题表 issue_id work_item_id | 缺陷与工作项关联 | 同一根因的重复发现可关联,不直接删除 |
| category severity found_stage | 分类、严重程度、发现阶段 | 定义事先确定,记录原判和裁决 |
| evidence repair_version recheck | 证据位置、修复版本、复验结论 | 必须形成关闭依据 |
| rule_id eligibility audit_selection | 规则编号、适用性、审计抽样信息 | 追踪覆盖率分母及漏检估计范围 |
指标计算时,事件间隔与主动工时分开:受理到首次开始主要反映排队;开始至结论可能包含暂停与返工;人工分钟数由活动日志取得,不能直接以墙钟间隔代替。一次查看、一次编辑与一次复验应分别编码,不能混称“介入次数”。
附录B 案例证据索引与公开版说明
案例A依据CalcAI_Engineering_V5_20260926.zip中的README.md、FINAL_SUMMARY.json及REFERENCE_GEOMETRY_CROSSCHECK.json。关键字段包括tasks_completed、anchor_hypotheses_executed、conditional_anchor_passes、anchor_ambiguity_resolved、reference_cases、manual_versions_passing_existing_engineering_gates和checked_locations。案例B依据Lung_V096_R1_20260926.zip中的README.txt及evidence/release-summary.json,核查cases数组、qc字段、professional_review和clinical_validation。以上用于固定版本的文档核查,未作为实时服务状态或临床金标准。
CalcAI_Engineering_V5_20260926.zip SHA-256 30204d6bd3517d0a88d1ec2c84a1b6316a3d466e9325ab10a5fbd40ac442a95d
Lung_V096_R1_20260926.zip SHA-256 f000a32dda4d1a50805c1e587a8d87f9fec061d7b0f6e71b7392ed2a7d4316ae
发布与研究状态:本公开版由子殷科技发布,属于方法学框架与研究方案,未经期刊同行评审。文中拟议干预尚未形成前瞻性效果数据;若进一步开展实证研究,需要冻结研究设计、收集统一日志并执行预定分析。
资料可用性:本文公开非识别性的工程摘要、研究方案与数据字典,不附原始患者影像、个体资料或内部交接包。上列文件名与摘要校验值用于标识所讨论的固定版本,不代表原始材料已公开获取。任何进一步的数据共享均需依相应授权范围办理。
机构关联:本文涉及子殷自身研发项目,发布机构与相关研发及业务存在直接关联。案例用于说明验证问题,不能作为独立的产品性能或疗效背书。
AI辅助说明:本文在文献检索、结构整理、语言表达、排版与网页制作中使用生成式AI辅助。AI不列为作者;该辅助过程不构成独立工程复核或临床验证。本文保留可核查的文献来源及明确的证据限制。
本次公开发布本身不代表启动新的临床研究、修改现有研发流程或阈值,也不构成产品部署决定。后续研究及应用须分别满足其对应的证据要求。
交流与讨论
欢迎交流研究方法、技术问题与实践经验。评论经审核后公开,子殷团队可在此回复。
公开讨论
正在加载讨论…